작업물을 불러오는 중…
블로그툴
블로그를 여러 개 등록해두고 전환하며 운영하는 데스크톱 허브. 주제 추천부터 초안 생성, 팩트체크, 이미지 수급, 기계 검사, 티스토리 발행까지 버튼 하나로 이어지고 마지막 클릭만 사람이 한다. 팩트체크는 권위 있는 출처의 본문을 실제로 읽어 확인하고, 못 읽은 출처는 이유를 남긴다.
스크린샷
개요
블로그를 여러 개 등록해두고 전환하며 운영하는 다중 블로그 허브입니다. 블로그마다 대주제와 플랫폼, 문체, 글자수 규칙을 따로 관리하고, 주제 발굴부터 초안 작성, 발행 화면 채우기까지 자동으로 처리한 뒤 마지막 [완료]·[발행] 버튼만 사람이 직접 누릅니다.
특정 홈페이지 하나에 종속돼 있던 이전 툴(blog-kit)을 일반화한 재제작 버전입니다. 대주제와 문체 규칙이 코드에 박혀 있어 블로그를 늘리려면 코드를 복제해야 했던 구조를, 블로그 프로필을 데이터(JSON)로 등록하고 전환하는 구조로 바꿨습니다.
핵심
제목 선정부터 프롬프트 생성, 초안 생성, 팩트체크, 이미지 수급, 기계검증까지가 [글 생성] 버튼 하나로 이어집니다. 중간 단계를 손으로 잇지 않습니다.
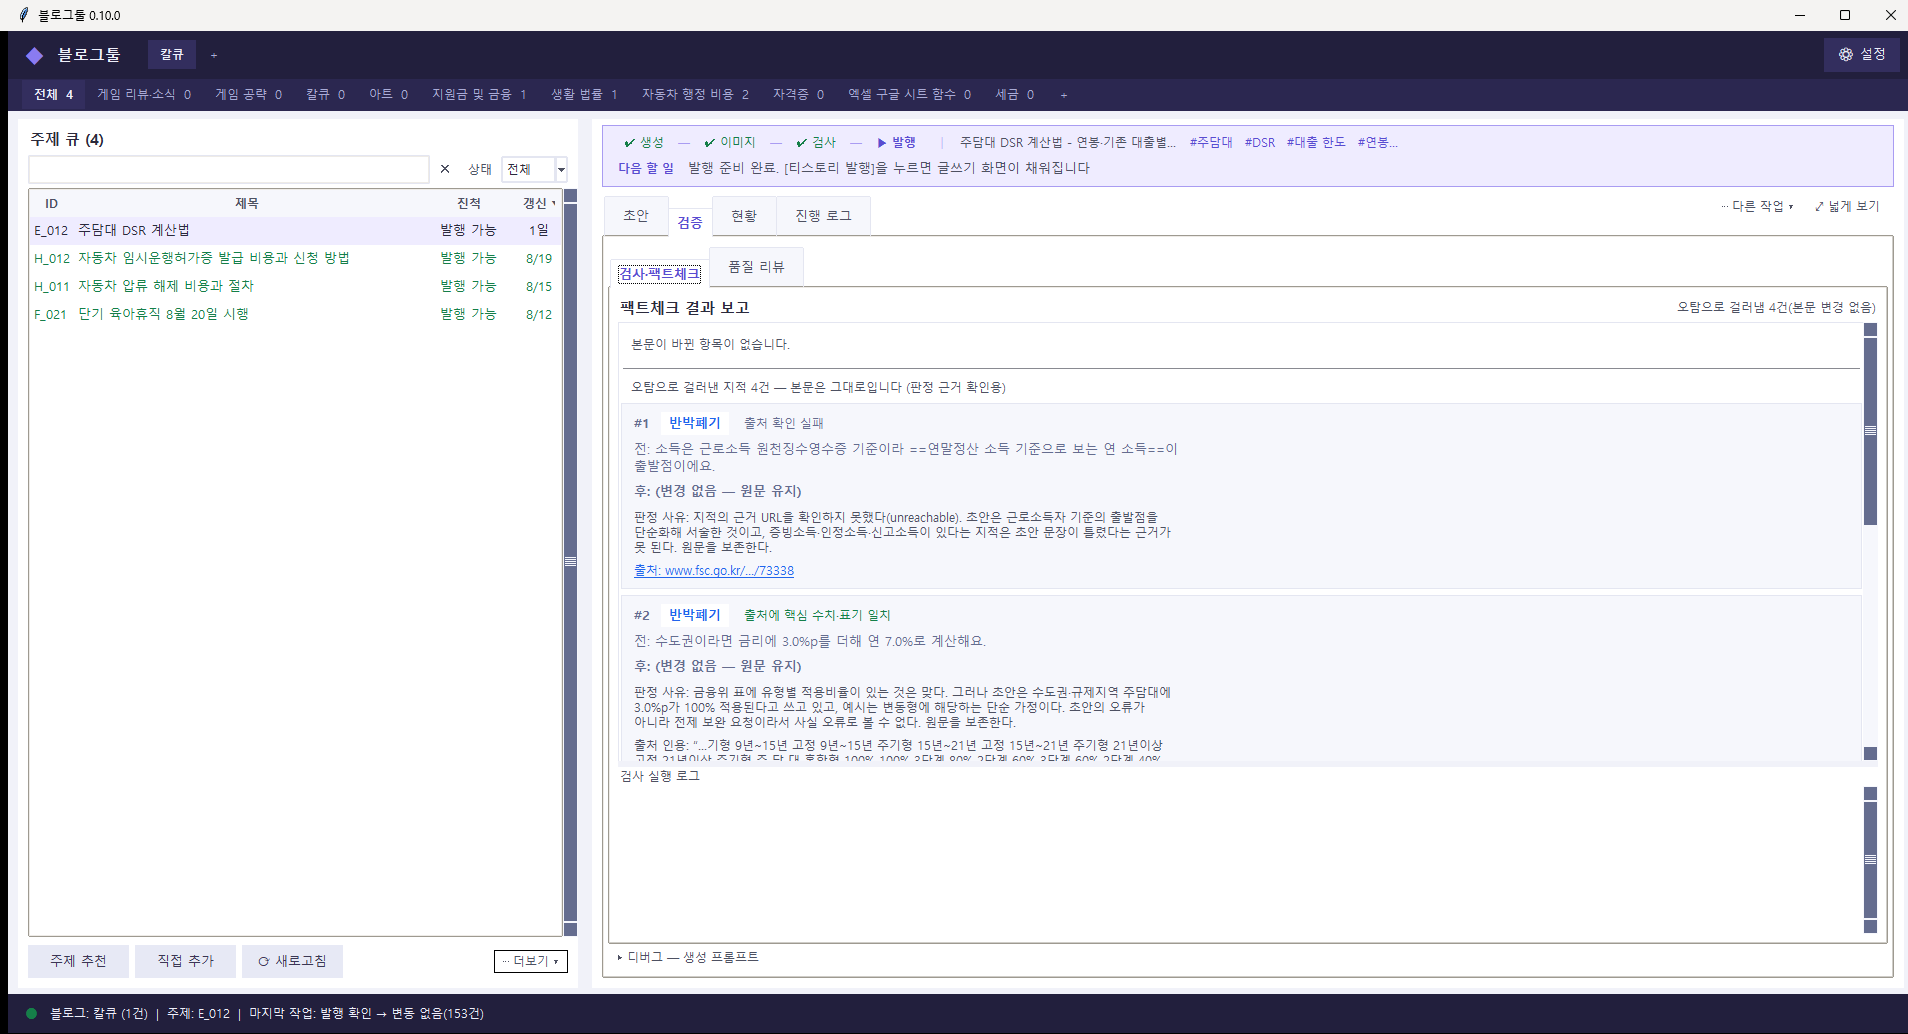
팩트체크는 게이트입니다. 생성된 본문의 수치와 주장을 웹 출처와 대조해 정정하거나 삭제하고, 판정 사유와 출처 인용을 리포트로 남깁니다. 근거를 못 찾은 문장은 본문에서 걷어냅니다.
발행 채널은 티스토리 하나로 정리했습니다. 전용 프로필 브라우저를 직접 조종해 제목·본문(이미지)·링크 카드·태그·카테고리까지 채우고, 붙여넣기가 실제로 끝났는지 에디터 화면을 다시 읽어 확인합니다. 무거운 초안은 채워지는 데 몇 초씩 걸리므로, 고정 대기 한 번이 아니라 마감시한까지 폴링합니다. 확인이 끝나면 [완료]·[발행]은 사람이 직접 누릅니다.
본문 이미지는 합성 카드 대신 정황 실사진을 첫 이미지로 씁니다. 카드 텍스트가 겹치거나 잘리는 것은 브라우저가 실제로 측정해 자동으로 고칩니다. 표나 수치가 필요한 글에는 실제 엑셀을 조작해 화면을 캡처합니다.
출처를 실제로 읽는 팩트체크
팩트체크가 짚어낸 오류가 확인 불가로 남을 때가 있었습니다. 국가법령정보센터처럼 권위 있는 사이트일수록 본문을 자바스크립트로 그려서, 기계가 페이지를 열어도 글자 수백 자만 손에 남았습니다. 정작 가장 믿을 만한 출처를 인용할 때 확인이 막히는 구조였습니다.
이제 사이트별로 본문을 실제로 읽어내는 방법을 따로 둡니다. 국가법령정보센터처럼 공식 API 로 조문 전문을 내려주는 곳은 그 API 를 먼저 쓰고, 판정 근거에도 국가법령정보센터 공식 API 라고 실제로 읽은 자리를 그대로 남깁니다. 이 방법으로 읽지 못하면 원래 페이지로 되돌아갑니다.
그래도 읽지 못하는 출처는 남습니다. 국세청 법령정보시스템처럼 공개 API 가 없는 곳입니다. 이때는 확인 불가 한 마디로 끝내지 않고 왜 못 읽었는지를 판정에 적습니다. 같은 내용을 다른 법령 출처로 확인할 수 있으면 그 안내도 함께 남습니다.
4대보험 요율 같은 숫자는 근거 없이 맞는지 틀린지를 가릴 수 없습니다. 국민연금·건강보험·고용보험·장기요양보험 요율을 법령 조문과 함께 표에 담아 두고, 본문에 적힌 숫자를 그 표와 기계가 직접 대조합니다. 대조에 쓰는 근거가 엉뚱한 법령이 아닌지도 이름을 맞춰 다시 확인합니다.
확인을 마치지 못한 지적은 더 이상 조용히 사라지지 않습니다. 검사 결과에 확인 필요 항목으로 나타나고, 발행 준비 화면은 그 항목부터 앞세웁니다.
내 컴퓨터 밖에서도 돌아가게
글을 쓰는 AI 를 세 가지로 늘렸습니다. Claude Code, Codex, 그리고 로컬 모델(Ollama 로 실행)입니다. 셋은 동등해서 어느 단계든 어느 쪽으로도 돌아갑니다.
단계마다 선호를 지정하지만 그건 선호일 뿐입니다. 지정한 것이 꺼져 있거나 없으면 남은 것으로 자동 대체하고, 하나도 못 쓸 때만 무엇을 어떻게 연결하면 되는지 말해 줍니다. 조용히 실패하지 않습니다.
받는 사람이 이 연결을 손으로 하나씩 하지 않아도 되게 [연결] 버튼을 더했습니다. CLI 가 없으면 설치(winget, 없으면 대체 스크립트)부터 로그인까지 이어가고, 키는 화면에 적어 넣기만 하면 실제로 한 번 호출해 유효한지 확인합니다. 블로그도 주소 하나만 넣으면 이름과 발행 검증 소스(사이트맵·RSS)를 스스로 찾아 채웁니다.
로그인 여부 판정도 다시 다졌습니다. CLI 를 npm 이 만든 셈 스크립트로 잘못 실행해 "로그인 필요"로 오판하던 경로를 네이티브 실행 파일과 진입 스크립트를 직접 해석하는 방식으로 고쳐, 구독으로 로그인해 쓰는 중인데 API 키 과금 경로로 새는 일을 막았습니다.
등록 없이도 일단 켜 볼 수 있게
첫 실행 순서를 AI 연결 → 주제 분야 → (선택) 블로그 주소로 바꿨습니다. 받는 사람이 자기 블로그 주소를 아직 안 정했더라도 일단 툴을 구경할 수 있습니다.
주제 분야를 고르려면 원래 블로그 레코드가 있어야 해서, 아무것도 등록하지 않았으면 뒤에서 조용히 기본 블로그 하나를 만들어 둡니다. 이미 있으면 손대지 않습니다. 이 단계가 끝났다고 표시하는 기준은 레코드가 생겼는지가 아니라 실제 발행할 주소를 입력했는지입니다. 자동으로 생긴 빈 블로그를 "설정 완료"로 잘못 표시하면 안 되기 때문입니다.
뼈대를 직접 짜는 [직접 구성]
[직접 추가]는 지금까지 이야기를 던지면 AI 가 주제 후보를 여러 개 내고 그중 고르는 방식뿐이었습니다. 고른 뒤의 구조(소제목 몇 개, 이미지 어디에)도 AI 가 정했습니다.
새 [직접 구성] 탭에서는 반대로 합니다. 글·이미지·영상·파일 블록을 원하는 순서로 직접 쌓아 뼈대(제목 → 태그 → 내용)를 사람이 먼저 짜고, AI 는 그 배치를 건드리지 않고 문장만 다듬습니다. 블록을 하나 더 끼워 넣거나 순서를 바꾸는 것은 고쳐 준 것이 아니라 규칙을 어긴 것으로 보고, 삭제·추가·순서변경 세 가지를 기계가 잡아냅니다.
낡은 합격은 합격이 아니다
검사를 통과한 뒤 본문을 고치면, 그 합격 표시는 더 이상 지금 본문에 대한 판정이 아닙니다.
그래서 검사 판정에 본문 지문을 붙였습니다. 본문이 바뀌면 예전 PASS 는 "재검사 필요"로 강등됩니다. 검사가 실패했거나 낡은 상태에서 발행 표시를 찍으려 하면 되묻습니다.
주제가 어느 단계인지도 저장된 상태값이 아니라 초안 파일이 실제로 있는지로 판정합니다. 상태값은 어긋나지만 파일은 어긋나지 않습니다. 작업이 갑자기 중단돼도 같은 원리로 이어집니다. 다시 켜면 어디까지 만들어졌는지를 산출물에서 다시 읽어 이어서 진행할지 사용자에게 묻습니다.
쌓인 것을 돌아보고 치우는 일
글이 쌓이면 목록에서 사라진 것들이 생깁니다. blog audit 은 이미 발행돼 목록에서 빠진 글을 다시 불러와 돌아보고, blog gc 는 남은 산출물의 재고를 세어 분류할 수 있는 것만 지웁니다. 정체를 모르는 파일은 손대지 않습니다.
발행 검증은 하나의 방식이 아니라 방식의 집합입니다. 축마다 근거를 따로 붙이고, Search Console 은 필요 없으면 해제할 수 있습니다.
스택
Python tkinter GUI(표준 라이브러리만)와 Node.js CLI 엔진(외부 의존성 없음). 데이터는 dynamic/(블로그·주제·소재)과 static/(설정·규칙)으로 계층 분리해 JSON 으로 보관하며, 서버도 DB 도 없는 완전 로컬 툴입니다.
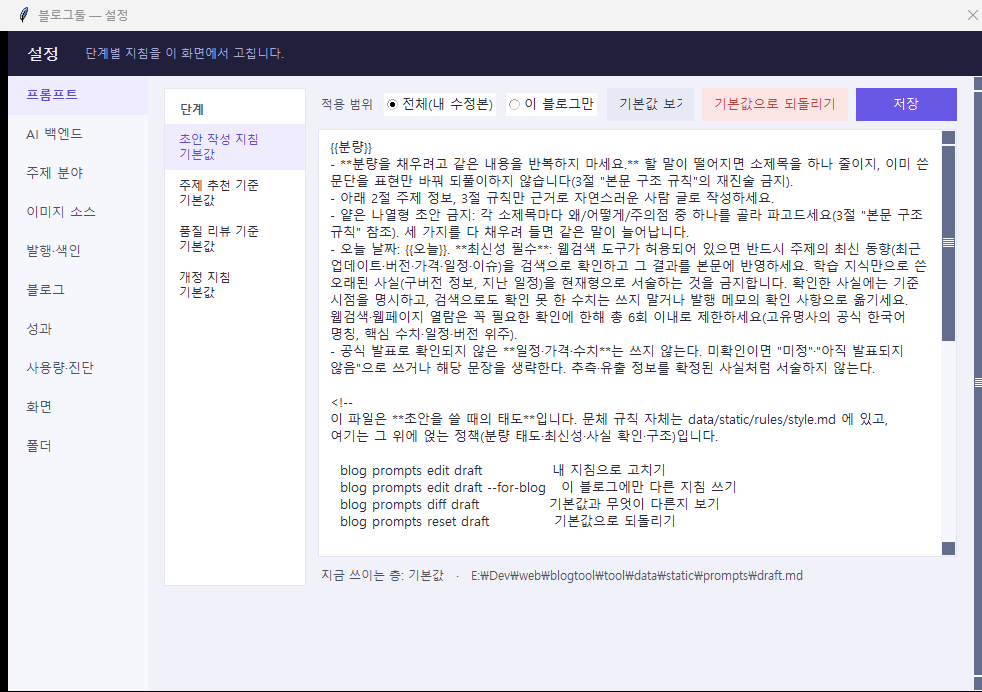
화면 전체 글씨 배율은 설정에서 조정합니다. 저장은 즉시 되고, 적용은 다시 시작할 때입니다. 이미 떠 있는 화면의 위젯은 크기를 따라오지 못하기 때문입니다.
현황
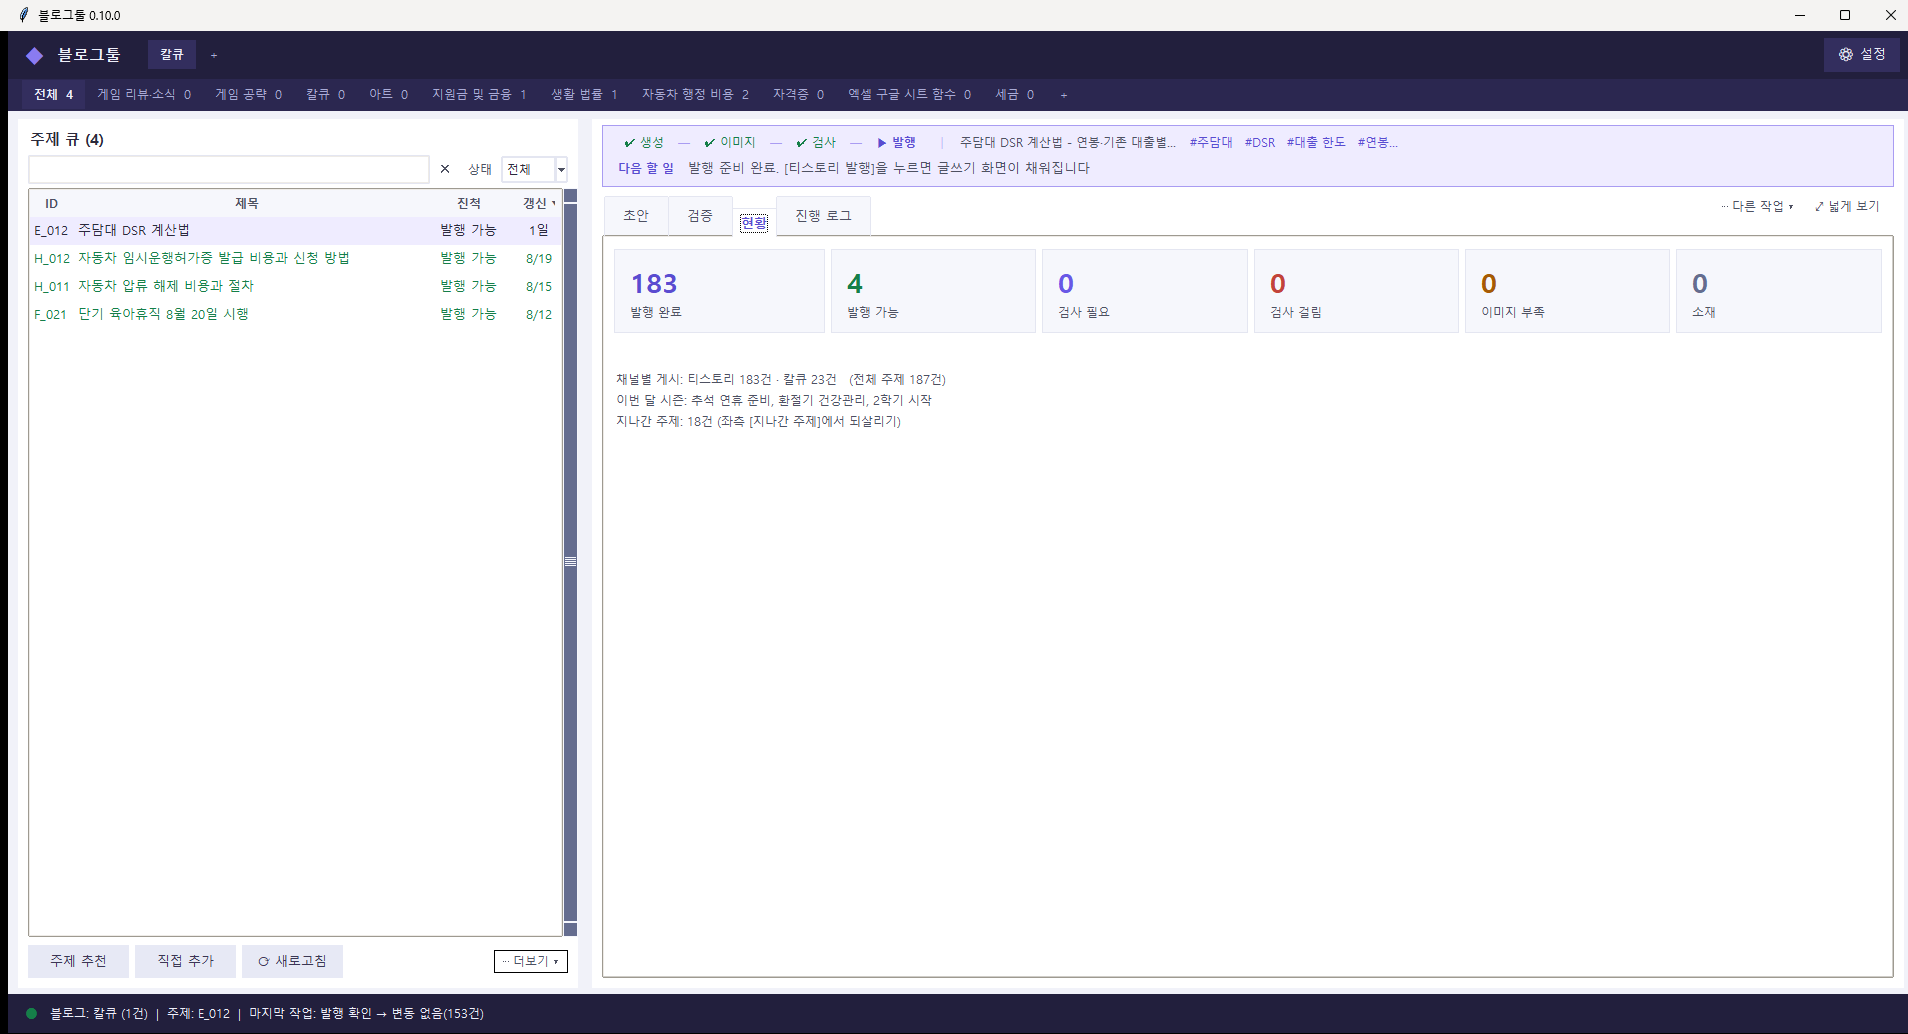
2026-09-29 기준 [현황] 탭을 보면 발행 완료 183건, 검사를 통과해 발행 가능한 글이 4건, 검사에 걸려 못 나간 글은 0건입니다. 채널별로는 티스토리 183건, 칼큐 23건이고 전체 주제는 187건입니다. 네이버 지원은 P13 에서 종료돼 더 이상 채널로 집계하지 않습니다.